Convertir le modèle entraîné au format TensorFlow Lite, puis le quantifier en entiers 8 bits pour réduire sa taille avant de l'embarquer sur un microcontrôleur
Quantification
Créée par : Lina Abousalama
Objectif
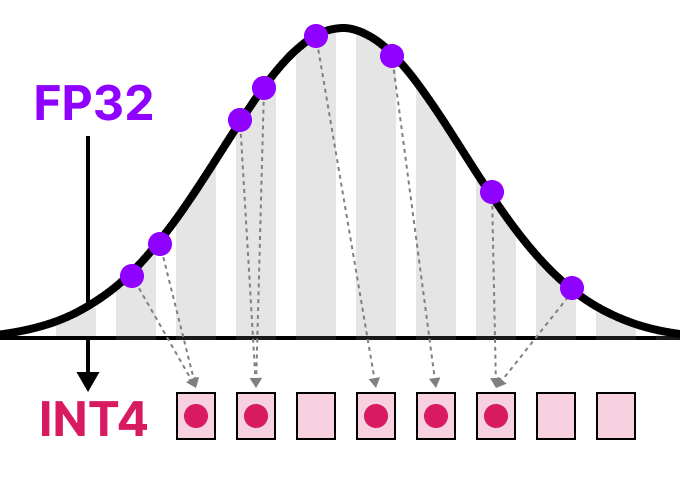
Le modèle entraîné stocke ses paramètres sous forme de nombres décimaux sur 32 bits (float32). C’est précis, mais trop lourd pour un microcontrôleur dont la mémoire est très limitée. Dans ce tutoriel, nous convertissons le modèle au format TensorFlow Lite, puis nous le quantifions : ses valeurs sont stockées en entiers sur 8 bits (int8) au lieu de 32 bits. Le modèle devient plus petit et plus rapide à exécuter, au prix d’une perte de précision éventuelle que nous mesurons.
À la fin de ce tutoriel, vous saurez :
- convertir un modèle Keras au format TensorFlow Lite ;
- quantifier un modèle en entiers 8 bits avec des images de calibration ;
- comparer la taille des modèles avant et après quantification ;
Convertir et quantifier le modèle
Nous convertissons d’abord le modèle en TensorFlow Lite. Puis nous le quantifions en int8 en fournissant des images qui permettent de calibrer les valeurs.
Étape 1 : Convertir le modèle en TensorFlow Lite (référence float32).
# Convertir le modèle Keras au format TensorFlow Lite
convertisseur = tf.lite.TFLiteConverter.from_keras_model(modele_cnn3)
modele_tflite_cnn3 = convertisseur.convert()

chemin_tflite = "/content/drive/MyDrive/modele_chat_chien_CNN3.tflite"

# Enregistrer le modèle converti dans un fichier
with open(chemin_tflite, "wb") as fichier:
    fichier.write(modele_tflite_cnn3)

print("Fichier créé :", os.path.exists(chemin_tflite))
print("Taille :", round(os.path.getsize(chemin_tflite) / 1024, 2), "Ko")
Le format TensorFlow Lite est une version allégée du modèle, conçue pour les appareils embarqués. À ce stade, les paramètres sont encore en float32 : ce fichier de 109,47 Ko.
Étape 2 : Quantifier le modèle en int8
La quantification remplace les nombres décimaux par des entiers entre -128 et 127. Pour choisir comment les convertir, le convertisseur a besoin d’observer les valeurs réelles que prend le modèle : c’est le rôle des images de calibration fournies par donnees_representatives.
# Fournir des images pour calibrer la quantification int8
def donnees_representatives():
    for images, etiquettes in train_data.take(100):
        image = images[:1].numpy().astype(np.float32)  # Prendre une image du lot
        yield [image]

# Préparer la conversion du modèle en TensorFlow Lite
convertisseur = tf.lite.TFLiteConverter.from_keras_model(modele_cnn3)
convertisseur.optimizations = [tf.lite.Optimize.DEFAULT]  # Activer les optimisations
convertisseur.representative_dataset = donnees_representatives  # Fournir les images de calibration
convertisseur.target_spec.supported_ops = [
    tf.lite.OpsSet.TFLITE_BUILTINS_INT8  # Utiliser les opérations int8
]
convertisseur.inference_input_type = tf.int8   # Entrée du modèle en int8
convertisseur.inference_output_type = tf.int8  # Sortie du modèle en int8

modele_cnn3_int8 = convertisseur.convert()  # Convertir et quantifier le modèle

# Définir le chemin de sauvegarde
chemin_tflite = "/content/drive/MyDrive/modele_chat_chien_CNN3_int8.tflite"

# Enregistrer le modèle quantifié
with open(chemin_tflite, "wb") as fichier:
    fichier.write(modele_cnn3_int8)

# Vérifier la création du fichier et afficher sa taille
print("Fichier créé :", os.path.exists(chemin_tflite))
print("Taille :", round(os.path.getsize(chemin_tflite) / 1024, 2), "Ko")
Le fichier passe de 109,47 Ko à 36,1 Ko, soit une réduction d’environ 67 %.
Conclusion
Nous avons converti le modèle au format TensorFlow Lite, puis quantifié en entiers 8 bits. Sa taille passe de 109,47 Ko à 36,1 Ko, soit environ trois fois moins. Ce modèle est assez petit et assez précis pour être embarqué.
Il reste à noter ses paramètres de quantification (échelle et point zéro d’entrée et de sortie), qui seront nécessaires pour préparer les images et lire le score sur le microcontrôleur.
L’étape suivante est le déploiement du modèle sur l’ESP32.