Envoyer les images du jeu de test à l'ESP32 par liaison série, récupérer le score du modèle quantifié pour chacune, puis calculer la matrice de confusion et la précision pour les comparer à celles de Colab
Évaluer le modèle sur l’ESP32
Créée par : Lina Abousalama
Objectif
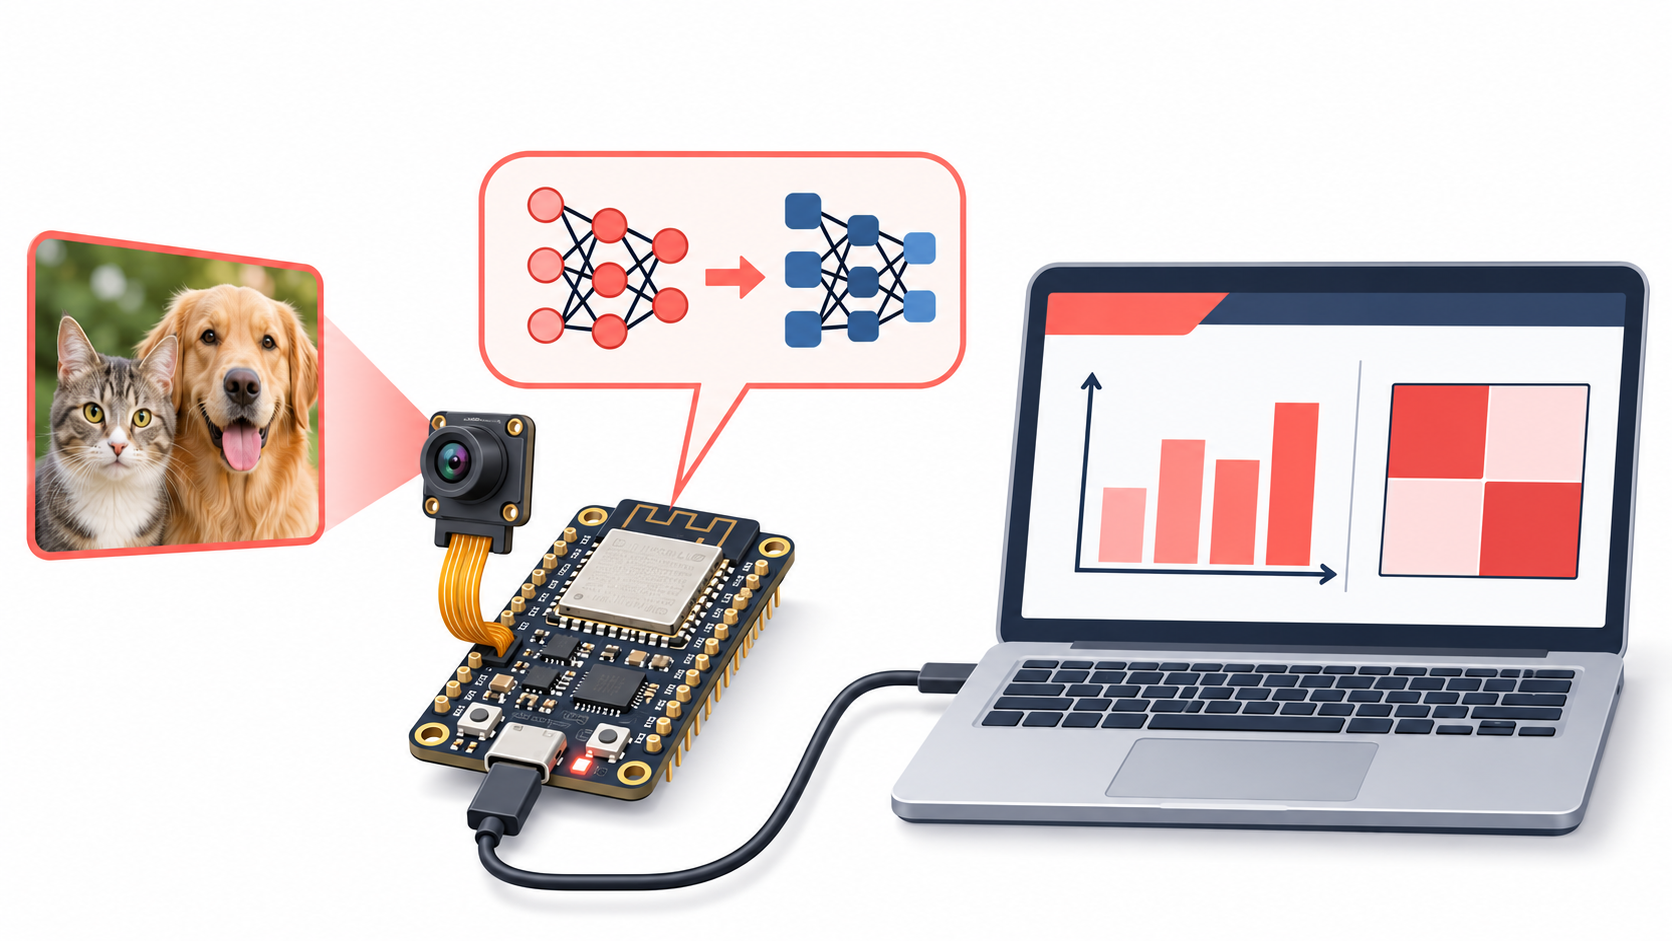
Le modèle quantifié s’exécute sur l’ESP32, mais nous ne savons pas encore s’il prédit aussi bien que sur Colab : la quantification en int8 peut modifier légèrement ses résultats. Dans ce tutoriel, nous testons le modèle sur la carte avec les 3 489 images du jeu de test préparé dans le tutoriel précédent. Un programme Arduino exécute le modèle, et un script Python sur l’ordinateur lui envoie les images une par une, récupère le score de chacune et construit la matrice de confusion.
À la fin de ce tutoriel, vous saurez :
- recevoir des images par liaison série sur l’ESP32 et exécuter le modèle sur chacune ;
- envoyer un jeu de test à la carte depuis un script Python ;
- calculer la matrice de confusion et la précision à partir des prédictions de l’ESP32 ;
- comparer ces résultats à ceux obtenus sur Colab.
Étape 1 : Créer le croquis Arduino
Dans Arduino IDE, créez un nouveau croquis (File > New Sketch), puis enregistrez-le sous le nom matrice-de-confusion : Arduino crée le dossier matrice-de-confusion dans votre dossier Arduino (par exemple C:\Users\VotreNom\Documents\Arduino). Copiez ensuite le fichier modele_chat_chien_CNN3_int8_model.h, situé dans C:\Users\VotreNom\Documents\Arduino\libraries\TFLiteMicro_ArduinoESP32S3, dans ce nouveau dossier.
Étape 2 : Récupérer le fichier du jeu de test
Téléchargez le fichier test_data.bin depuis Google Drive. Placez-le dans le nouveau dossier.
Étape 3 : Ajouter et téléverser le programme de test
Ouvrez le nouveau croquis Arduino et remplacez son contenu par le code ci-dessous. Ce programme charge le modèle quantifié, reçoit les images envoyées par l’ordinateur et renvoie un score pour chacune.
#include <Arduino.h>
#include "esp_heap_caps.h"

#include "tensorflow/lite/schema/schema_generated.h"
#include "tensorflow/lite/c/common.h"
#include "tensorflow/lite/micro/micro_interpreter.h"
#include "tensorflow/lite/micro/micro_mutable_op_resolver.h"

#include "modele_chat_chien_CNN3_int8_model.h"

constexpr int TAILLE_MEMOIRE = 400000;
constexpr int TAILLE_IMAGE = 96 * 96 * 3;

tflite::MicroMutableOpResolver<5> resolveur;
tflite::MicroInterpreter* interpreteur = nullptr;
TfLiteTensor* entree = nullptr;
TfLiteTensor* sortie = nullptr;

// Reçoit une image du PC, la passe dans le modèle et renvoie son score
void traiterImage() {
  uint8_t classe;   // la vraie classe, envoyée par le PC (inutile ici, mais à lire)

  bool recu =
      Serial.readBytes(&classe, 1) == 1 &&
      Serial.readBytes(reinterpret_cast<uint8_t*>(entree->data.int8),
                       TAILLE_IMAGE) == TAILLE_IMAGE;
  if (!recu) {
    while (Serial.available()) Serial.read();   // vider ce qui reste
    Serial.println("ERR_RECEPTION");
    return;
  }

  if (interpreteur->Invoke() != kTfLiteOk) {
    Serial.println("ERR_MODELE");
    return;
  }

  float score = (sortie->data.int8[0] - sortie->params.zero_point)
                * sortie->params.scale;
  Serial.printf("S,%.4f\n", score);
}

void setup() {
  Serial.setRxBufferSize(32768);   // une image entière tient dans le tampon
  Serial.begin(115200);
  Serial.setTimeout(5000);         // attente maximale des octets d'une image
  delay(1000);

  if (!psramFound()) {
    Serial.println("PSRAM non detectee.");
    return;
  }

  uint8_t* memoire = static_cast<uint8_t*>(heap_caps_aligned_alloc(
      16, TAILLE_MEMOIRE, MALLOC_CAP_SPIRAM | MALLOC_CAP_8BIT));
  if (memoire == nullptr) {
    Serial.println("Allocation de la memoire echouee.");
    return;
  }

  // Opérations utilisées par le CNN
  resolveur.AddConv2D();
  resolveur.AddFullyConnected();
  resolveur.AddLogistic();
  resolveur.AddMaxPool2D();
  resolveur.AddMean();

  const tflite::Model* modele =
      tflite::GetModel(TFLM_modele_chat_chien_CNN3_int8_model);

  static tflite::MicroInterpreter interp(
      modele, resolveur, memoire, TAILLE_MEMOIRE);
  interpreteur = &interp;

  if (interpreteur->AllocateTensors() != kTfLiteOk) {
    Serial.println("Erreur : impossible de preparer le modele.");
    return;
  }

  entree = interpreteur->input(0);
  sortie = interpreteur->output(0);
  Serial.println("Modele pret. En attente du PC.");
}

void loop() {
  if (interpreteur == nullptr || !Serial.available()) return;

  char commande = Serial.read();
  if (commande == 'R') Serial.println("PRET");        // le PC demande si on est prêt
  else if (commande == 'I') traiterImage();           // une image arrive
  else if (commande == 'F') Serial.println("FIN");    // fin du test
}
Étape 4 : Fermer le Moniteur série
Après avoir téléversé le programme, fermez le Moniteur série d’Arduino IDE. Le script Python, que nous exécuterons à l’étape suivante, doit pouvoir accéder au port série pour communiquer avec l’ESP32.
Étape 5 : Lancer le test depuis l’ordinateur
Dans le dossier matrice-de-confusion, créez un fichier Python nommé test_esp32.py, puis copiez-y le code ci-dessous et enregistrez-le. Ouvrez ensuite l’invite de commandes dans ce dossier et exécutez la commande python test_esp32.py.
Avant de lancer le script, installez ses deux bibliothèques avec la commande py -m pip install pyserial numpy. Attention : il faut installer pyserial et non serial, qui est un autre paquet.
import os
import time
import numpy as np
import serial

PORT = "COM9"                 # Port affiché dans Arduino IDE > Outils > Port
FICHIER = "test_data.bin"     # 1 octet de classe + 27 648 octets de pixels par image
SEUIL = 0.57

TAILLE_IMAGE = 96 * 96 * 3
TAILLE_BLOC = 1 + TAILLE_IMAGE
NB_IMAGES = os.path.getsize(FICHIER) // TAILLE_BLOC

# Attendre que l'ESP32 réponde « PRET »
ser = serial.Serial(PORT, 115200, timeout=2)
time.sleep(2)  # La carte peut redémarrer à l'ouverture du port

for essai in range(5):
    ser.reset_input_buffer()
    ser.write(b"R")

    if ser.readline().strip() == b"PRET":
        break
else:
    ser.close()
    raise SystemExit(
        "Pas de réponse de l'ESP32 (mauvais port ou moniteur série ouvert ?)"
    )

ser.timeout = 10

# Matrice : lignes = classes réelles, colonnes = classes prédites
# 0 = chat, 1 = chien
matrice = np.zeros((2, 2), dtype=int)

print(f"Test sur {NB_IMAGES} images...")

with open(FICHIER, "rb") as f:
    for i in range(NB_IMAGES):
        bloc = f.read(TAILLE_BLOC)

        vraie_classe = bloc[0]
        pixels = np.frombuffer(bloc[1:], dtype=np.uint8)

        # Convertir les pixels uint8 [0, 255] en int8 [-128, 127]
        image_int8 = (pixels.astype(np.int16) - 128).astype(np.int8)

        # Envoyer l'image à l'ESP32 par petits morceaux
        donnees = b"I" + bytes([vraie_classe]) + image_int8.tobytes()

        for debut in range(0, len(donnees), 512):
            ser.write(donnees[debut:debut + 512])
            ser.flush()
            time.sleep(0.002)

        # Lire le score renvoyé par l'ESP32
        reponse = ser.readline().decode(errors="ignore").strip()

        if not reponse.startswith("S,"):
            ser.close()
            raise SystemExit(
                f"Image {i} : réponse inattendue de l'ESP32 : {reponse!r}"
            )

        score = float(reponse[2:])
        classe_predite = 1 if score >= SEUIL else 0

        matrice[vraie_classe][classe_predite] += 1

        if (i + 1) % 500 == 0:
            precision_provisoire = 100 * np.trace(matrice) / matrice.sum()
            print(
                f"{i + 1}/{NB_IMAGES}, "
                f"précision provisoire : {precision_provisoire:.1f} %"
            )

# Signaler la fin du test et fermer la connexion
ser.write(b"F")
ser.close()

# Afficher la matrice de confusion
print("\nMatrice de confusion")
print("                 Prédit chat  Prédit chien")
print(f"Vrai chat        {matrice[0][0]:11d}  {matrice[0][1]:12d}")
print(f"Vrai chien       {matrice[1][0]:11d}  {matrice[1][1]:12d}")

precision = 100 * np.trace(matrice) / matrice.sum()
print(f"\nPrécision globale : {precision:.2f} %")
Lire et comparer les résultats
Pour référence, voici la matrice de confusion du modèle float32 sur le même jeu de test, obtenue sur Colab dans le tutoriel sur la modélisation.
| Prédit chat | Prédit chien | |
|---|---|---|
| Vrai chat | 1 538 | 182 |
| Vrai chien | 248 | 1 521 |
Précision : 87,68 %.
Voici la matrice obtenue sur l’ESP32 avec le modèle quantifié :
| Prédit chat | Prédit chien | |
|---|---|---|
| Vrai chat | 1 569 | 151 |
| Vrai chien | 291 | 1 478 |
La précision est de 87,33 % : 3 047 images sont correctement classées sur 3 489. Sur Colab, le modèle float32 obtenait 87,68 %. La quantification en int8 fait donc perdre environ 0,35 point, soit 12 images de plus mal classées (442 erreurs contre 430).
Les erreurs se déplacent légèrement : l’ESP32 prend moins de chats pour des chiens (151 contre 182) mais plus de chiens pour des chats (291 contre 248). Ces écarts peuvent venir de la quantification et de l’arrondi des pixels dans test_data.bin.
Conclusion
Nous avons testé le modèle quantifié sur l’ESP32 avec les 3 489 images du jeu de test. La carte atteint 87,33 % de précision, contre 87,68 % sur Colab : la quantification en int8 ne dégrade que très peu les résultats, alors que le modèle est environ trois fois plus petit (36,1 Ko contre 109,47 Ko). La matrice de confusion montre que les erreurs restent réparties dans les deux sens, avec un peu plus de chiens classés comme des chats.
Le modèle est donc assez précis pour être utilisé tel quel sur la carte, avec la caméra.